안녕하세요. 자바파커입니다.
정렬 알고리즘의 시간복잡도는 다들 외웁니다. 버블은 O(n²), 퀵은 O(n log n). 그런데 이게 실제로 얼마나 차이 나는지는 잘 와닿지 않습니다.
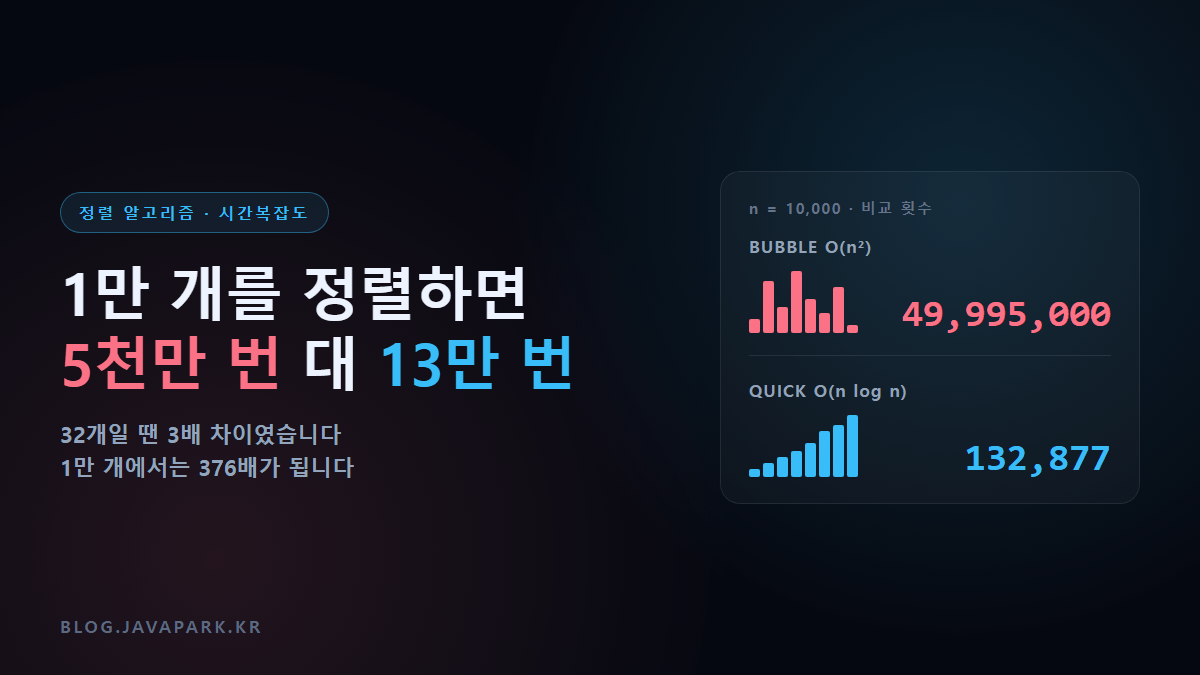
숫자로 보면 이렇습니다.
| 원소 수 | 버블 n(n-1)/2 |
퀵 n log₂n |
배수 |
|---|---|---|---|
| 32 | 496 | 160 | 3배 |
| 1,000 | 499,500 | 9,965 | 50배 |
| 10,000 | 49,995,000 | 132,877 | 376배 |
| 1,000,000 | 499,999,500,000 | 19,931,568 | 25,085배 |
원소가 32개일 때는 3배 차이지만, 1만 개에서는 376배가 됩니다. 복잡도 표기가 무서운 이유가 여기 있습니다. 작은 입력에서 잰 감각이 큰 입력에서 완전히 무너집니다.
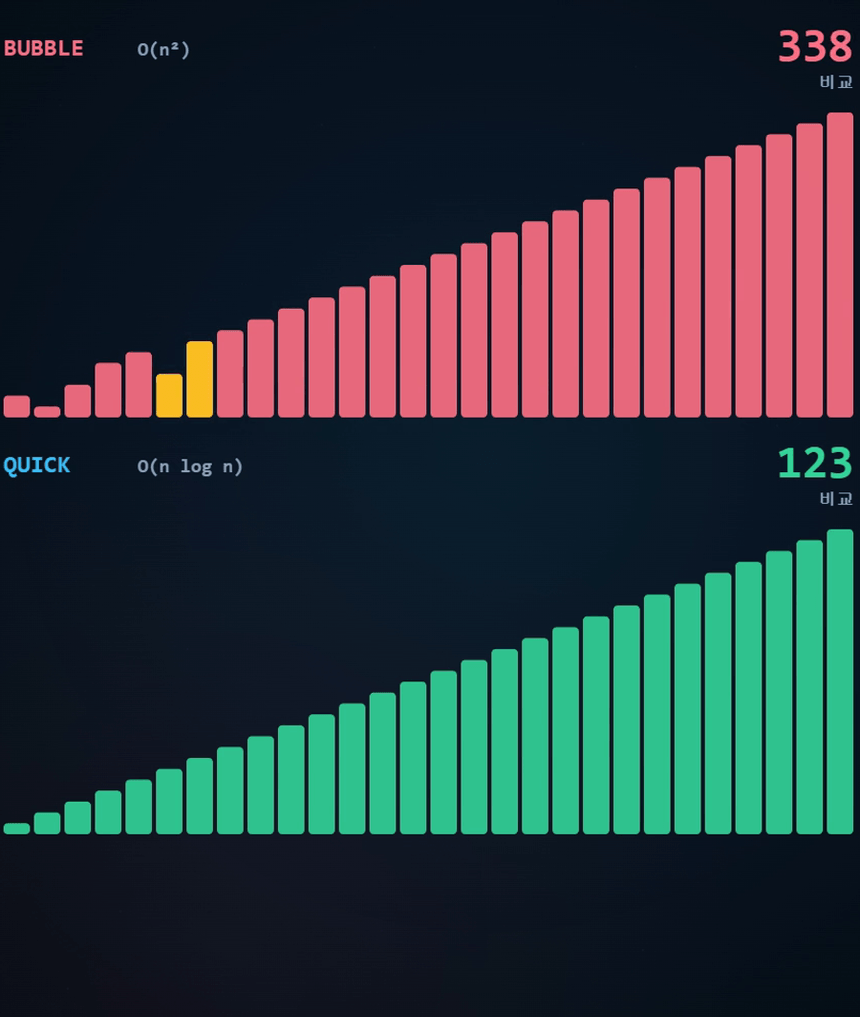
같은 배열 28개를 두 알고리즘으로 동시에 돌린 1분 영상으로도 정리했습니다. 퀵이 먼저 끝나고도 버블이 계속 세고 있는 구간이 이 차이의 전부입니다.
O(n²) 세 형제 — 무엇이 다른가
버블·선택·삽입은 모두 O(n²)지만 실제 동작은 꽤 다릅니다.
버블 정렬 — 옆 사람과만 비교한다
인접한 두 개를 비교해서 순서가 틀렸으면 바꿉니다. 한 바퀴 돌 때마다 가장 큰 값이 맨 뒤로 밀려납니다.
function bubbleSort(a) {
  for (let i = 0; i < a.length - 1; i++) {
    let swapped = false
    for (let j = 0; j < a.length - 1 - i; j++) {
      if (a[j] > a[j + 1]) {
        ;[a[j], a[j + 1]] = [a[j + 1], a[j]]
        swapped = true
      }
    }
    if (!swapped) break // 이미 정렬됐으면 조기 종료
  }
  return a
}
비교는 항상 n(n-1)/2번이지만 교환은 역순 쌍(inversion)의 개수만큼 일어납니다. 거의 정렬된 배열이면 swapped 검사로 한 바퀴 만에 끝납니다.
선택 정렬 — 교환이 가장 적다
남은 구간에서 최솟값을 찾아 맨 앞과 한 번 바꿉니다. 교환 횟수가 정확히 n-1번으로 고정입니다.
비교는 버블과 같은데 교환이 압도적으로 적습니다. 원소 하나를 옮기는 비용이 비쌀 때(큰 구조체를 값으로 다룰 때) 의미가 있습니다.
삽입 정렬 — 거의 정렬된 배열에 강하다
앞에서부터 하나씩 꺼내 이미 정렬된 앞부분의 제자리에 꽂습니다.
function insertionSort(a) {
  for (let i = 1; i < a.length; i++) {
    const key = a[i]
    let j = i - 1
    while (j >= 0 && a[j] > key) {
      a[j + 1] = a[j]
      j--
    }
    a[j + 1] = key
  }
  return a
}
이미 정렬된 배열에서는 비교가 n-1번뿐이라 O(n)입니다. 이 성질 때문에 삽입 정렬은 지금도 현역입니다 — 뒤에서 다시 나옵니다.
O(n log n)은 어디서 오는가
log n은 절반으로 나누는 횟수입니다. 1,000개를 절반씩 쪼개면 10번 만에 1개가 되고, 100만 개는 20번이면 됩니다.
1,000,000 → 500,000 → 250,000 → … → 1
              20번
한 단계마다 전체 n개를 한 번씩 훑으니 n × log n이 됩니다.
병합 정렬 — 나눠서 합친다
절반으로 계속 쪼갠 뒤, 정렬된 두 배열을 합칩니다. 합치는 건 양쪽 맨 앞만 비교하면 되므로 선형입니다.
function merge(l, r) {
  const out = []
  let i = 0,
    j = 0
  while (i < l.length && j < r.length) {
    // 같을 때 왼쪽을 먼저 넣는 것이 안정 정렬의 조건이다
    out.push(l[i] <= r[j] ? l[i++] : r[j++])
  }
  return out.concat(l.slice(i), r.slice(j))
}
최악에도 O(n log n)을 보장하고 안정 정렬입니다. 대신 합칠 공간이 필요해 메모리를 O(n) 더 씁니다.
퀵 정렬 — 기준 하나로 갈라낸다
피벗을 하나 정하고 그보다 작은 것과 큰 것으로 나눕니다. 그리고 각 구역에서 같은 일을 반복합니다.
추가 메모리를 거의 안 쓰고(제자리 정렬), 상수가 작아 실제로 가장 빠른 축입니다.
다만 피벗이 계속 한쪽으로 치우치면 O(n²)가 됩니다. 이미 정렬된 배열에서 맨 앞을 피벗으로 잡으면 매번 1개와 n-1개로 갈라져 최악이 나옵니다.
그런데 실무에서는 이 중 하나만 쓰지 않는다
표준 라이브러리의 정렬은 교과서 알고리즘 하나가 아니라 섞은 것입니다.
| 런타임 | 정렬 | 구성 |
|---|---|---|
| V8 (JavaScript) | Timsort | 병합 + 삽입 |
| Python | Timsort | 병합 + 삽입 |
| Java 원시 타입 | Dual-Pivot Quicksort | 퀵 + 삽입 |
| Java 객체 | Timsort | 병합 + 삽입 |
Rust sort_unstable |
pdqsort | 퀵 + 힙 + 삽입 |
세 가지 아이디어가 공통으로 들어갑니다.
1. 작은 구간은 삽입 정렬로 넘긴다. 원소가 16~32개 이하로 줄면 O(n log n) 알고리즘의 재귀 오버헤드가 오히려 큽니다. 앞에서 본 대로 삽입 정렬은 작고 거의 정렬된 구간에 강합니다.
2. 이미 정렬된 구간을 알아본다. Timsort는 배열을 훑으며 오름차순·내림차순 구간(run)을 찾아 그대로 씁니다. 실제 데이터는 완전 무작위인 경우가 드물기 때문입니다.
3. 최악을 감시한다. pdqsort와 introsort는 재귀가 너무 깊어지면 힙 정렬로 전환합니다. 퀵 정렬의 O(n²)를 구조적으로 막습니다.
Node.js의 Array.prototype.sort가 Timsort라는 점은 V8 공식 블로그에 정리돼 있습니다. V8 — Getting things sorted in V8
안정 정렬이 중요한 순간
같은 값끼리의 원래 순서가 유지되는가가 안정성입니다.
주문 목록을 먼저 날짜로 정렬하고, 그다음 금액으로 정렬한다고 해봅시다.
orders.sort((a, b) => a.date - b.date)
orders.sort((a, b) => a.amount - b.amount)
안정 정렬이면 금액이 같은 주문들 사이에서는 날짜 순서가 남습니다. 불안정 정렬이면 그 순서가 깨집니다.
| 정렬 | 안정성 |
|---|---|
| 버블·삽입·병합 | 안정 |
| 선택·퀵·힙 | 불안정 |
JavaScript는 ES2019부터 Array.prototype.sort가 안정 정렬로 명세에 못박혔습니다. 그전에는 엔진마다 달랐습니다.
JavaScript에서 자주 밟는 함정
sort()를 비교 함수 없이 부르면 원소를 문자열로 바꿔 비교합니다.
;[10, 9, 100, 1].sort()
// [1, 10, 100, 9]  ← 문자열 사전순
;[10, 9, 100, 1].sort((a, b) => a - b)
// [1, 9, 10, 100]
그리고 sort()는 원본 배열을 바꿉니다. 원본을 지켜야 하면 toSorted()(ES2023)를 쓰거나 복사한 뒤 정렬합니다.
const sorted = [...list].sort((a, b) => a - b)
const sorted2 = list.toSorted((a, b) => a - b)
정리
| 알고리즘 | 평균 | 최악 | 메모리 | 안정 | 쓰이는 곳 |
|---|---|---|---|---|---|
| 버블 | O(n²) | O(n²) | O(1) | O | 교육용 |
| 선택 | O(n²) | O(n²) | O(1) | X | 교환 비용이 클 때 |
| 삽입 | O(n²) | O(n²) | O(1) | O | 작거나 거의 정렬된 구간 |
| 병합 | O(n log n) | O(n log n) | O(n) | O | 최악 보장이 필요할 때 |
| 퀵 | O(n log n) | O(n²) | O(log n) | X | 범용 기본값 |
| 힙 | O(n log n) | O(n log n) | O(1) | X | 최악 방어용 |
핵심은 하나입니다. 복잡도 차이는 입력이 커질 때만 드러납니다. 32개에서 3배였던 차이가 1만 개에서 376배가 되고, 100만 개에서는 2만 5천 배가 됩니다. 반대로 원소가 20개뿐이라면 삽입 정렬이 퀵 정렬보다 빠릅니다 — 실제 표준 라이브러리가 그렇게 동작합니다.
자주 묻는 것
Q. 그래서 직접 구현할 일이 있나요? A. 거의 없습니다. 표준 라이브러리가 교과서 알고리즘보다 빠릅니다. 다만 왜 빠른지는 알아야 합니다. "거의 정렬된 데이터를 다시 정렬하는 비용"이나 "정렬 두 번으로 다중 키 정렬하기" 같은 판단이 여기서 나옵니다.
Q. 퀵 정렬이 최악 O(n²)면 위험하지 않나요? A. 실무 구현은 그냥 퀵 정렬이 아닙니다. 중앙값 피벗을 고르고, 재귀가 깊어지면 힙 정렬로 바꿉니다(introsort). 사용자 입력이 최악 케이스를 만들어 서비스를 느리게 하는 공격도 이 방식으로 막습니다.
Q. O(n log n)보다 빠른 정렬은 없나요?
A. 비교 기반 정렬은 O(n log n)이 하한입니다. 다만 비교를 안 쓰면 더 빠를 수 있습니다. 계수 정렬·기수 정렬은 값의 범위가 제한적일 때 O(n)에 가깝게 동작합니다. 대신 범용성이 없습니다.